スキップしてメイン コンテンツに移動

変分法の可視化

Introduction


今日は、変分法の可視化を実装しました。変分法は、汎関数を最小化させるために使われます。汎関数とは、関数の関数のようなものです。変分法については、 [1],[2],[3],[5], [6]などを参考にしてください。

概要
  • 汎関数
  • 実装
  • 可視化

汎関数
今回は、次のような汎関数を使います。
$$F(x) = \sqrt{1+(\frac{du}{dx}(x))^2}$$
$$l(u) = \int_{0}^{1} \sqrt{1+(\frac{du}{dx}(x))^2} dx$$

l(u)はu(x)という曲線の長さです。. 
$u(0)=a$ and $u(1)=b$という制約のもと、$l(u)$を最小化したいといます。
最適な$l(u)$は
$$u(x) = (b-a)x+a$$
となります。

(0,a) から (1,b)への直線になっているのがわかります。
これは、$l(u)$は$u$の曲線の長さなので、これを最小化するためには直線が一番であることが直観的にわかります。

変分法での導出は、[5]を参考にしてください。

実装
変分法における最適な曲線とそうでない曲線の違いを可視化する実装をしました。
$u_A$を
$$u_A = (b-a)x+a + A sin(8t)$$
とします。
$A sin(8t)$ は$u$から話す役割を持ちます。. $A \in [0,0.5]$であり、もし$A=0$であれば、$u_A=u$です。

githubでcodeを公開しています。


可視化
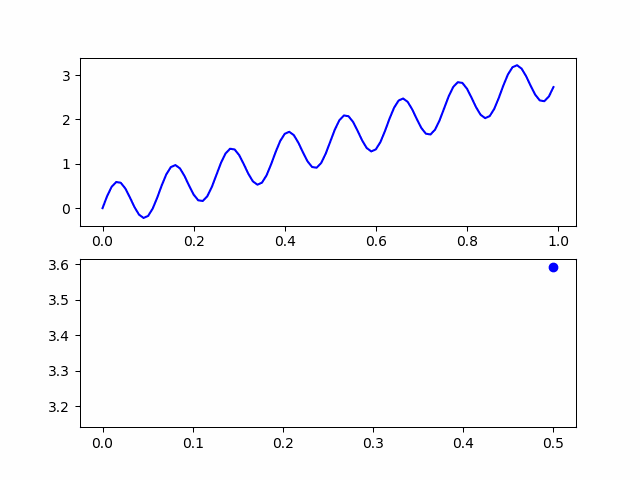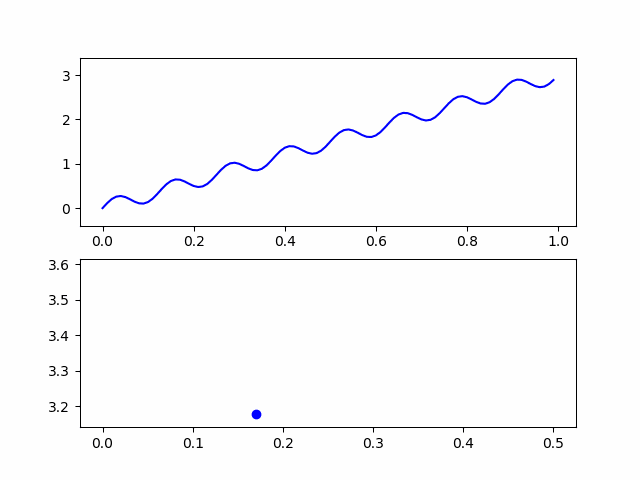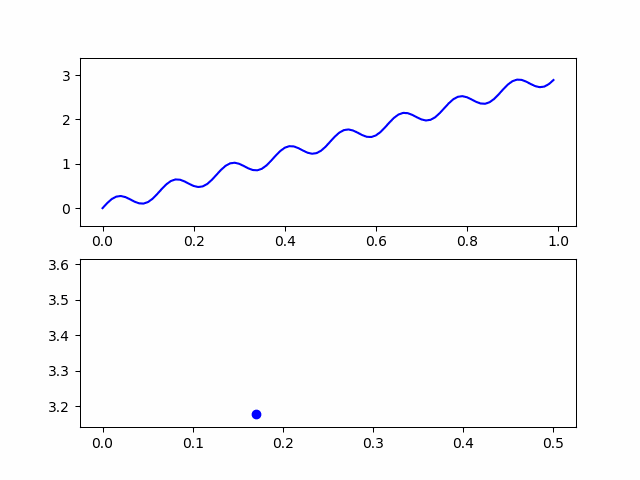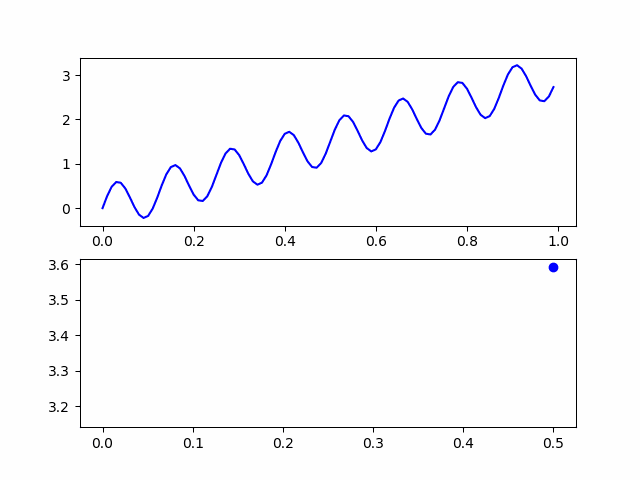
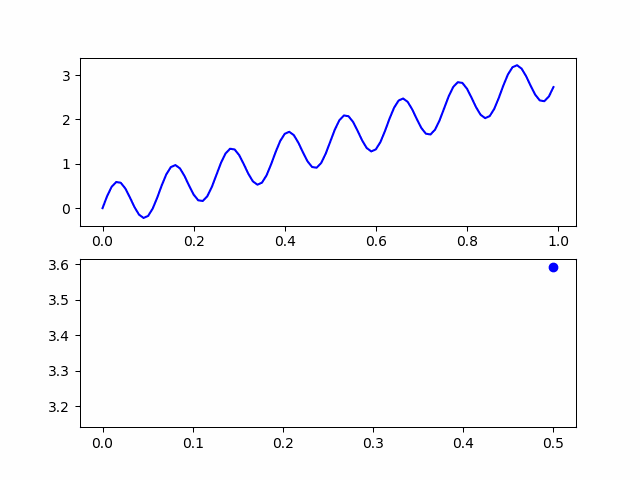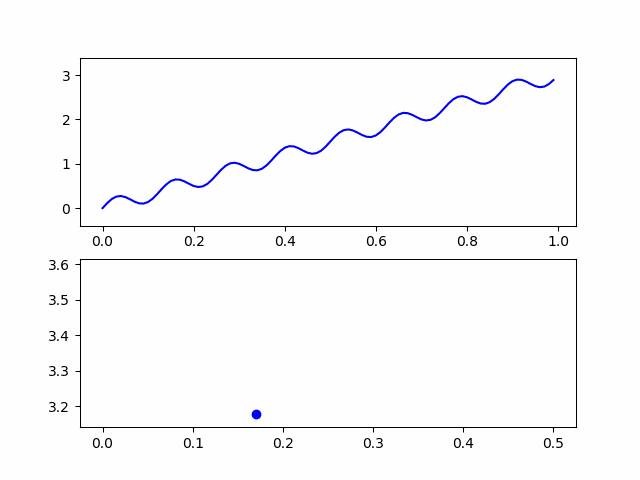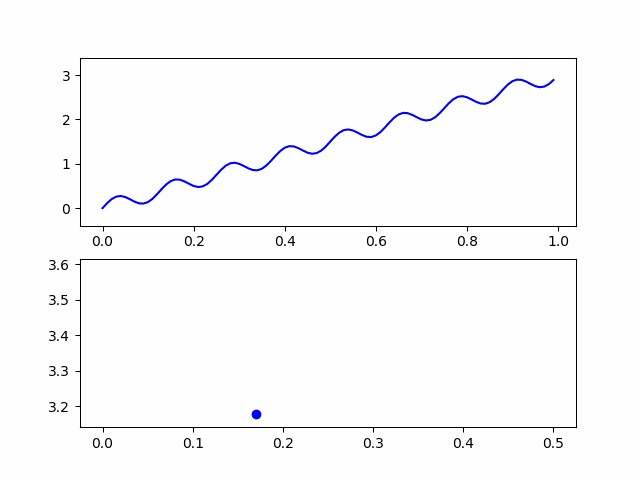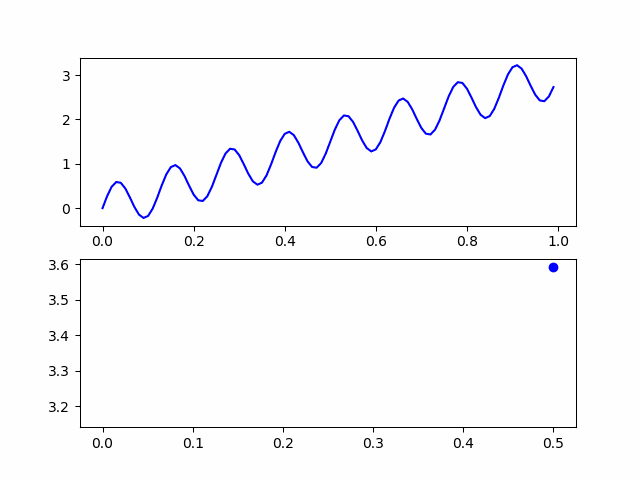
上側の画像は$u_A(x)$を表しています。下側の画像は$l(u_A)$の値を表しています。
$u_A(x)$が$u$に近づくほど、$l(u_A)$が小さくなることがわかります。


Reference
[1]http://www2.kaiyodai.ac.jp/~takenawa/optimization/resume10-4.pdf
[2]http://hooktail.sub.jp/mathInPhys/brachisto/
[3]http://eman-physics.net/math/differential21.html
[4]http://bicycle1885.hatenablog.com/entry/2014/02/14/023734
[5]http://www2.kaiyodai.ac.jp/~yoshi-s/Lectures/Optimization/2013/lecture_6.pdf
[6]http://www.qi.mp.es.osaka-u.ac.jp/personal/imoto/index-j/jugyou/Kaiseki170427.pdf

コメント

このブログの人気の投稿

Implementation of Robbins monro

Robbins monro の実装 sorry, this page is Japanese only.   今回はRobbins monro の実装をしてみました。 Robbins monroは確率勾配降下法の学習率を入りテーション回数の逆数で割っていくものです。 使っているprogram言語はpython 3です。osはwindowsです。(macほしい...) アルゴリズム 確率勾配降下方とは目的関数の最適解を求めるアルゴリズムです。目的関数をf(X)とすると、手順は以下のようになっています。 初期学習率$n_0$を決めます。訓練データDを用意します。この訓練データは複数の初期値の集まりです。 訓練データから一つ初期値をランダムに取り出し、これを$x_0$とし、最初の予測値とします。 次の式に現在の予測値$x_0$を代入し、新たな予測値$x_{n+1}$を得ます。$$x_{n+1} = x_{n} - \frac{n_0}{n} grad f(X_n)$$ 収束して入れば4へ、収束していなければ2で得られた値$x{n+1}$を新たに$x_n$としてもう一度2を行う。 訓練データを一周していなければ2へ、一周していれば各初期値から得られた解の中から目的関数を最も小さくするものを選ぶ。   実装例 以下の目的関数を最小化させてみましょう。 $$f(x,y) = (x-2)^2 + (y-3)^2 $$ コマンドラインでpythonを実行していきます。 予想通り、(2,3)という解を導き出してくれました。目的関数が簡単だったので、初期値をどの値でとってもばっちり正解にたどり着いてくれました。 CODE 以下にRobbins monroの関数だけ置いておきます。 こちら にすべてのコードを載せています。 def Robbins_monro(function,grad,number_variable_gradient): init_learning_rate = 1.5 stepsize = 1000 init_value = np.array([range(-1000,1020,20) for i in range(number_v...

カーネルSVMの実装

Introduction English ver 今日はカーネルSVMを実装しました。 最適化には内点法を実装しました。 この記事では実装のみ書いていますが、理論編もそのうちに書きたいと思います。書き次第、リンクを貼っておきます。 # 第一弾書きました。 SVMの理論 part 1 僕のcomputerはwindowsでOSもwindowsです。 実装はPython3で行います。 概要 カーネルとは データセットについて 実装の結果 カーネルとは カーネルとは非線形問題を解くための手法です。 直線で分類できないようなデータをある写像をもとで、直線で分類できるような分布に変形することです。次の画像を見たほうがわかりやすいかもしれません。 ⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓⇓↓ このように変形することをカーネルトリックといいます。 変形されたデータは写像\(\phi\)によって\(\phi(x)\)と表現されます。 \[\phi:x -> \phi(x)\] しかし、SVMではカーネル関数は次のように表されることが多いです。 \[K(x,y)=\phi(x)^T \phi(y)\] なぜなら、SVMでは \(\phi(x)^T \phi\)のみを計算するからです。 最もよく使われているカーネルはRBFとpolynomialです。 RBF \[K(x,y) = \exp(-\gamma ||x-y||^2)\] polynomial \[K(x,y) = (x^Ty+c)^p\] \(K(x,y) = x^Ty\)とすればこれは線形SVMになります。 データセット 今日使うデータセットはnp.random.randnによって生成された正規分布に従う乱数です。 と このデータを作ったコードは ここ に置いてあります。 Implementation 今回はRBFカーネルを使いました。 \(\gamma = 0.5\) 正規化係数50とすると次のようになりました。 次に二つ目のデータセットに対して、RBF kernelを使いました。 \(\gamma = 0.5\) 正規化係数を100とすると、次のよ...

Plane in two dimention

Introduction 日本語 ver Today, I prove this theorem. Plane in two dimention is expressed following. \[\{x|<x,v> = 0\}\] however, v is orthogonal vector for plane and not zero vector. Proof \[\forall k \in \{x|<x,v> = 0\},\] k is fulfill this form. \[<k,v> = 0\] Now, because k and v in two dimentinal space, each vector express following. \[k = (k_1,k_2)\] \[v = (v_1,v_2)\] Thus, \(<k,v>=k_1v_1 + k_2v_2=0\) Change this equation. \[k_2 = -\frac{v_1}{v_2} k_1\] This equation is plane that slope is \(-\frac{v_1}{v_2}\). Q.E.D